Без выходных: 9:30–20:00
Выявляем скрытые закономерности в больших массивах данных
Создаем архитектуру, готовую к росту нагрузок и объемов
Оцениваем эффективность моделей понятными бизнес-показателями
Внедряем ML-пайплайны в существующую ИТ-инфраструктуру
Делимся примерами проектов, где SEO, разработка и комплексный подход приносят измеримый рост трафика, заявок и продаж.
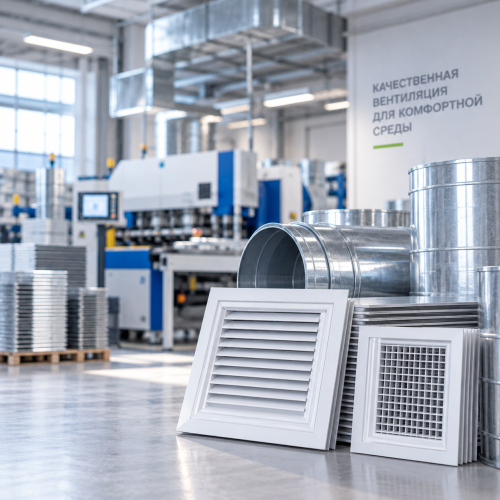
Все кейсыКомплексно оптимизировали интернет-магазин вентиляционных решеток и увеличили поисковый трафик с 2,7 до 11,2 тыс. визитов в месяц
Начало работ: май 2025
Тематика: Вентиляция, Производство.
Услуги: SEO-продвижение
Результат: х4 трафик из поисковых систем
Разработали сайт, расширили семантику и поисковую видимость — органический трафик вырос с нуля до 19,3 тыс. визитов в месяц
Разработка и SEO продвижение сайта грузоперевозок: сформировали стабильный органический трафик — первые 100+ посетителей из поисковых систем в день.
Оставьте заявку — обсудим задачу и подберём решение под ваш бизнес.
Услуга включает комплексный набор технических работ по созданию решений на базе машинного обучения. Мы проводим аудит данных, конструируем признаки, проектируем архитектуру и обучением алгоритмы. В состав сервиса также входит валидация метрик, развертывание модели в инфраструктуре и выстраивание регулярного мониторинга в рамках MLOps для постоянного поддержания актуальности прогнозов.
Изучаем бизнес-контекст задачи и проводим экспертную оценку качества, полноты и структуры имеющихся исторических датасетов. Определяем целевые математические метрики качества будущего алгоритма и согласовываем их связь с ключевыми показателями бизнеса.
Разработка сайтов, SEO-продвижение и внедрение AI-решений для бизнеса.
Senior Web Developer · SEO · AI
Создание эффективного алгоритма машинного обучения происходит по прозрачной и предсказуемой траектории. Мы шаг за шагом ведем проект от первичной постановки задач и технического аудита данных до проектирования архитектуры, серии проверочных тестов и последующего развертывания готовой системы в вашей ИТ-инфраструктуре с полной поддержкой.
На старте проекта команда проводит серию глубинных встреч с представителями заказчика. Мы подробно фиксируем ключевые цели организации, имеющиеся технические ограничения и измеримые экономические показатели, к которым должно привести внедрение ML-разработки в конечные процессы.
Специалисты выполняют полную ревизию доступных датасетов, CRM-систем и внутренних логов. Мы проверяем полноту и качество исторической информации, определяем ее пригодность для обучения предиктивных алгоритмов и своевременно находим пробелы в текущих каналах сбора данных.
Инженеры формируют детальное техническое задание и подбирают надежный стек технологий. На этом этапе закладывается архитектура безопасного перемещения информации: от получения сырых сведений из первоисточников до автоматической передачи готовых решений конечным пользователям.
Мы собираем первичное упрощенное ML-решение для подтверждения базовых гипотез на практике. Это позволяет с минимальными затратами оценить потенциал датасета, зафиксировать стартовые математические метрики и подтвердить техническую реализуемость поставленной задачи.
Проводится планомерный циклический процесс развития модели: мы усложняем архитектуру, генерируем новые признаки и настраиваем гиперпараметры. Каждая итерация обучения приближает точность работы системы к нормативным показателям, утвержденным в техническом задании.
Завершенная модель проходит комплексную проверку устойчивости в связке с ИТ-инфраструктурой предприятия. Инженеры проводят нагрузочное тестирование, оценивают показатели latency при проведении inference и проверяют обработку нетипичных входящих запросов.
Осуществляется окончательный deployment подготовленного ML software в рабочую среду или на изолированные сервера заказчика. Процесс включает настройку отказоустойчивых контейнеров, обеспечивающих стабильное функционирование сервисов при любых пиковых нагрузках.
На финальном этапе выстраиваются автоматизированные пайплайны регулярного дообучения алгоритмов и дашборды отслеживания качества предсказаний. Мы передаем проект вашей инхаус-команде с детальной документацией или берем сервис на непрерывное техническое сопровождение.
Заказ разработки ML-моделей становится актуальным, когда предприятие накапливает масштабные исторические данные, но традиционные методы аналитики перестают приносить результат. Классические жесткие правила систем ломаются при усложнении процессов, а ручная обработка потока информации замедляет принятие решений. Переход на машинное обучение позволяет автоматизировать рутину, выявить скрытые паттерны и сохранить высокую конкурентоспособность.
Компания годами собирает информацию о клиентах, операциях или оборудовании, но этот датасет лежит мертвым грузом без коммерческой пользы. Стандартные BI-системы не способны находить скрытые признаки и многомерные связи в терабайтах сырых записей. Текущие отчеты дают только картинку прошлого, не позволяя прогнозировать будущее. Внедрение специализированной ML-модели превращает массив информации в точные предиктивные инсайты, гарантируя быстрый переход к принятию решений на основе данных.
Система уперлась в потолок из-за сотни жестких правил, которые постоянно конфликтуют и требуют ручного переписывания под изменения рынка. Запрограммированная логика становится слишком громоздкой, а поддержка кода отнимает ресурсы ИТ-отдела. Обучение моделей машинного обучения позволяет развернуть гибкий ML pipeline, который самостоятельно адаптируется к новым условиям и корректно обрабатывает нестандартные сценарии, снижая нагрузку на инженеров и исключая критические ошибки.
При обработке скоринговых заявок, динамическом ценообразовании или отслеживании фрода счет идет на миллисекунды. Человеческий фактор и медлительные сервисы вызывают задержки, приводя к оттоку клиентов и финансовым потерям. Выполнение процесса в режиме реального времени требует высоконагруженной инфраструктуры, где deployment готового алгоритма обеспечивает быструю фазу inference. Внедрение MLOps позволяет непрерывно обрабатывать тысячи запросов в секунду без потери точности.
Оценим рынок, конкурентов и потенциал
Подберём оптимальные каналы и инструменты
Покажем реальные ожидаемые результаты
Составим пошаговый план сроки и бюджет
Покажем, как работаем на реальных кейсах
Делимся опытом и результатами
Внедрение ML-разработки переводит управление компанией на проактивную основу, где ключевые решения опираются на точную аналитику данных. Бизнес получает качественный рост производительности, максимальную точность прогнозирования и резкое сокращение издержек. Это создает технологическое превосходство над конкурентами и дает устойчивый рост маржинальности.
Алгоритмы снимают с сотрудников необходимость ручной обработки информации и принятия повторяющихся решений. Это оптимизирует использование трудовых ресурсов, исключает ошибки human-factor и ускоряет выполнении операций в разы.
Умные рекомендации и динамическое ценообразование предлагают покупателям нужные товары в самый подходящий момент. Это существенно поднимает конверсию, повышает средний чек продажи и улучшает показатель пожизненной ценности клиента.
Предиктивные модели выявляют аномалии и предотвращают убытки до их появления. Компания защищена от атак, нецелевых расходов, простоев оборудования и неожиданных кассовых разрывов благодаря точному планированию.
Система принимает решения без влияния человеческих факторов, эмоций и усталости. Управление строится на базе точных математических данных, что минимизирует риски ошибок и повышает прозрачность процессов.
Кластеризация и скоринг клиентов позволяют направлять рекламный бюджет строго на целевую аудиторию. Компания снижает стоимость привлечения покупателей и получает кратный рост окупаемости инвестиций в продвижение.
Созданные ML-пайплайны легко адаптируются к возрастающим объемам данных без потери скорости. Цифровая инфраструктура готова к кратному увеличению нагрузки при активном расширении и выходе на новые рынки.
Качественная ML-разработка базируется на современной экосистеме инструментов, выбор которых зависит от архитектуры данных и бизнес-целей. В качестве основного языка программирования выступает Python, предоставляющий гибкие возможности для манипуляции данными, математического моделирования и быстрого прототипирования.
Для работы с классическими предиктивными задачами и табличными выборками мы используем библиотеки Scikit-learn, XGBoost, LightGBM и CatBoost, показывающие максимальную точность на структурированных данных. Если проект требует глубокого обучения, обработки естественного языка (NLP) или компьютерного зрения (Computer Vision), применяются фреймворки PyTorch и TensorFlow.
Ключевое место в нашей работе занимает организация непрерывного цикла разработки. Инфраструктура MLOps строится на базе следующего стека:
Технологии машинного обучения трансформируют традиционные процессы, превращая накопленная данные в прямой финансовый результат. Разработка ML-решения позволяет компаниям перейти от реактивной аналитики к проактивному управлению и точному прогнозированию.
В ритейле и e-commerce предиктивные алгоритмы рассчитывают оптимальную динамическую стоимость товаров, прогнозируют локальный спрос и снижают объем неликвидных остатков на складах. Финансовый сектор и финтех-сервисы внедряют predictive models для скоринга заемщиков в режиме реального времени, оценки кредитных рисков и немедленного выявления аномальных транзакций.
В промышленности и логистике машинное обучение решает задачи предиктивного обслуживания оборудования (Preventive Maintenance), предотвращая внезапные поломки и дорогостоящие простои. Алгоритмы анализируют показатели датчиков телеметрии и заранее информируют инженеров о необходимости ремонта компонентов.
Выбор между классическими алгоритмами машинного обучения и глубокими нейросетями (Deep Learning) определяется типом исходной информации, ее объемом и требованиями к интерпретируемости результатов.
Классический ML (регрессия, деревья решений, случайные леса) эффективен при работе со структурированными табличными данными. Он требует обязательного этапа Feature Engineering, когда эксперты вручную создают и отбирают информативные признаки. Главные преимущества подхода — высокая скорость training, низкие требования к вычислительным ресурсам и понятная интерпретируемость предсказаний.
Глубокое обучение основывается на многослойных нейросетевых архитектурах (CNN, RNN, Transformers). Оно показывает превосходящие результаты при обработке неструктурированной информации:
Deep Learning автоматически извлекает абстрактные фичи из сырых данных, но требует огромных обучающих выборок, специализированных GPU-серверов и сложной процедуры валидации.
Чтобы заказать ML-разработку и успешно запустить модель в эксплуатацию, предприятию необходимо подготовить базовый фундамент на уровне данных и вычислительных мощностей. Отсутствие системного подхода к инфраструктуре часто становится причиной задержек при выводе решений в продакшен.
Первоочередная задача — наладить надежные процессы сбора, централизации и хранение сырых данных. Данные из CRM, ERP и внешних источников должны поступать в единое хранилище (Data Lake или Data Warehouse) с настроенными ETL/ELT-процедурами и протоколами контроля качества (Data Quality).
На этапе развертывания готовой системы требуется предусмотреть целевую среду для inference (обработки входящих запросов):
Грамотно подготовленная ИТ-среда гарантирует бесшовный deployment и стабильную работу алгоритмов без деградации скорости ответа при росте числа пользователей.
Выберите тип задачи, расскажите о ней, каким вы видите решение и результат:
ИП Липаткин Павел Евгеньевич ИНН 661224380098 ОГРНИП 325665800174229