Без выходных: 9:30–20:00
Интеграция с внутренними базами знаний и документацией
Быстрый доступ к точной информации по запросу сотрудника
Подтверждение каждого ответа ссылками на первоисточники
Масштабирование системы без дообучения языковой модели
Делимся примерами проектов, где SEO, разработка и комплексный подход приносят измеримый рост трафика, заявок и продаж.
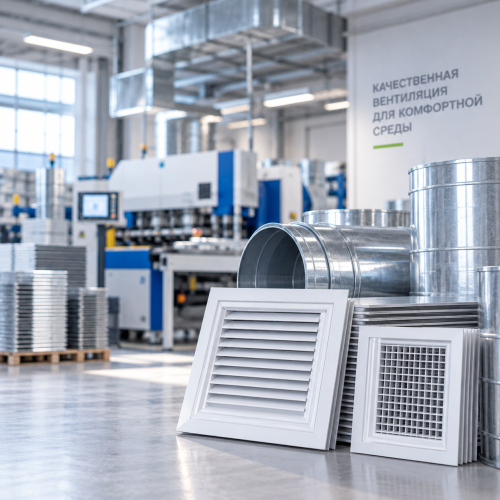
Все кейсыКомплексно оптимизировали интернет-магазин вентиляционных решеток и увеличили поисковый трафик с 2,7 до 11,2 тыс. визитов в месяц
Начало работ: май 2025
Тематика: Вентиляция, Производство.
Услуги: SEO-продвижение
Результат: х4 трафик из поисковых систем
Разработали сайт, расширили семантику и поисковую видимость — органический трафик вырос с нуля до 19,3 тыс. визитов в месяц
Разработка и SEO продвижение сайта грузоперевозок: сформировали стабильный органический трафик — первые 100+ посетителей из поисковых систем в день.
Оставьте заявку — обсудим задачу и подберём решение под ваш бизнес.
Комплексная услуга включает все технические этапы создания умного поиска: от подготовки неструктурированных данных и создания векторных индексов до программирования алгоритмов реранжирования, безопасной интеграции нейросетей и разработки интерфейсов. Мы создаем готовое инженерное решение, полностью готовое к работе в вашей серверной инфраструктуре.
Выполняется первичный сбор и нормализация исходных корпоративных файлов в форматах PDF, Word, HTML и базах данных. Осуществляется автоматическая очистка текста от визуального мусора и настраивается алгоритмический чанкинг — разделение больших массивов на оптимальные смысловые блоки для точного распознавания контекста.
Разработка сайтов, SEO-продвижение и внедрение AI-решений для бизнеса.
Senior Web Developer · SEO · AI
Процесс создания корпоративной RAG-системы строится на четкой последовательности технических этапов. Мы начинаем с глубокого анализа исходных данных и проектирования архитектуры, после чего последовательно выстраиваем конвейер обработки, векторизацию, механизмы поиска и интеграцию с LLM. Каждая стадия логически вытекает из предыдущей, завершаясь тестированием качества и безопасным запуском в инфраструктуру.
На стартовом этапе проводим анализ корпоративных источников данных, оценивая их форматы, объемы и действующие права доступа. На основе полученных параметров проектируем высокоуровневую архитектуру RAG-системы и подбираем стек технологий, включая векторные базы данных, фреймворки и подходящие языковые модели под задачи проекта.
Разрабатываем автоматизированный ETL-пайплайн для извлечения информации из внутренних хранилищ компании. Выполняем очистку от технического мусора, нормализацию содержимого и конфигурируем алгоритмы чанкинга, разбивающие исходные документы на оптимальные смысловые фрагменты с сохранением исходной структуры текста.
Генерируем векторные представления для всех подготовленных текстовых чанков с помощью моделей эмбеддингов. Полученные данные загружаем и индексируем в специализированной векторной базе, создавая оптимизированную структуру для мгновенного выполнения семантического поиска по всему объему загруженной информации.
Программируем компонент Retriever, комбинирующий гибридный семантический и лексический поиск. Подключаем специализированную модель реранжинга для повторной сортировки найденных фрагментов, что обеспечивает передачу в языковую модель только наиболее точных и контекстуально релевантных блоков информации.
Выполняем подключение языковой модели через API или разворачиваем локальное решение в контуре компании. Проводим настройку системных инструкций и промпт-инжиниринг, формируя жесткие ограничения для нейросети, гарантирующие генерацию ответов исключительно на основе извлеченного контекста без сторонних фантазий.
Создаем удобный интерфейс взаимодействия в виде веб-приложения, диалогового виджета или корпоративного бота. Реализуем функционал сохранения истории запросов, визуального отображения первоисточников информации с кликабельными ссылками на документы и внедряем элементы оценки точности ответов пользователями.
Осуществляем всестороннюю валидацию разработанной RAG-системы с применением метрик RAGAS и TruLens. Проводим серии тестов на отсутствие галлюцинаций, полноту извлечения контекста и точность формулировок, а также тестируем устойчивость инфраструктуры к пиковым нагрузкам перед финальным развертыванием.
Выполняем развертывание готового решения в промышленном контуре заказчика и настраиваем фоновое автообновление индексов при изменении файлов. Проводим обучающие сессии для персонала по работе с системой и обеспечиваем последующее техническое сопровождение функционирующего сервиса.
Внедрение корпоративной RAG-системы становится необходимым при накоплении гигабайтов внутренних регламентов и резком снижении скорости поиска нужных данных. Стандартные инструменты поиска не способны анализировать смысл документов, а использование публичных нейросетей создает серьезные риски утечки коммерческой тайны. Разработка персонального решения позволяет объединить все базы данных компании в единый безопасный контур и получить мгновенный доступ к точной информации.
В корпоративных хранилищах компании накоплены терабайты документации, но сотрудники не могут оперативно найти нужные сведения. Традиционный лексический поиск по ключевым словам не справляется с объемом и выдает сотни релевантных файлов вместо точного фрагмента текста. Это приводит к простоям в работе и регулярным задержкам при выработке рабочих решений. Разработка RAG-систем решает эту проблему путем перехода к семантическому анализу смыслов, обеспечивая мгновенный выдачу нужного ответа со ссылкой на документ.
На этапе онбординга стажеры и новые сотрудники вынуждены постоянным потоком однотипных вопросов отвлекать высокооплачиваемых ключевых специалистов от их приоритетных задач. Изучение регламентов по локальным дискам занимает недели, а риски совершения критических ошибок возрастают. Стандартные инструкции быстро устаревают, вызывая путаницу в процессах. Внедрение корпоративной RAG-системы позволяет автоматизировать консультирование новичков, создавая персонального AI-наставника с мгновенным доступом к базе знаний.
Операторы первой линии технической поддержки слишком долго ищут ответы по сложным спецификациям продуктов или передают клиентам устаревшие данные из-за частых обновлений линейки. Жесткие скрипты не закрывают нестандартные вопросы, а ручной поиск в базе занимает много времени, что ухудшает метрики сервиса. Применение технологии Retrieval-Augmented Generation дает операторам умный инструмент, который автоматически анализирует запрос и находит верную информацию, повышая скорость обслуживания.
Оценим рынок, конкурентов и потенциал
Подберём оптимальные каналы и инструменты
Покажем реальные ожидаемые результаты
Составим пошаговый план сроки и бюджет
Покажем, как работаем на реальных кейсах
Делимся опытом и результатами
Внедрение технологии Retrieval-Augmented Generation преобразует работу с корпоративной информацией, оптимизируя ключевые процессы. Компания получает измеримый рост производительности труда за счет экономии тысяч рабочих часов, существенное снижение финансовоемких ошибок и мгновенную отдачу от инвестиций благодаря автоматизации рутинных коммуникаций.
Персонал компании больше не тратит рабочие часы на длительное чтение регламентов или ожидания ответов от коллег. Система отдает точные выжимки по запросам за доли секунды, сохраняя фокус специалистов на выполнении профильных задач и резко увеличивая общую скорость выполнения проектов.
Все генерируемые решения и ответы опираются исключительно на утвержденные регламенты и действующие корпоративные стандарты. Вы полностью исключаете риски использования неактуальных документов или неверных трактовок, обеспечивая безупречную точность всех рабочих процессов.
Процесс онбординга новых кадров происходит без постоянного отвлечения старших менторов. Персональный виртуальный ассистент выдает новичкам проверенную информацию с прямыми ссылками на первоисточники, помогая оперативно освоить внутренние правила и быстрее приносить пользу.
Интеллектуальная система берет на себя обработку подавляющей массы повторяющихся вопросов клиентов и сотрудников. Это позволяет ощутимо сократить затраты на содержание первой линии поддержки и высвободить квалифицированные кадры для решения нестандартных и сложных задач.
Использование изолированных архитектур гарантирует сохранение коммерческой тайны внутри вашего закрытого периметра. Бизнес получает все преимущества передового искусственного интеллекта без малейшей угрозы попадания конфиденциальных сведений в сторонние сети.
Накопленный годами опыт и разнородные документы объединяются в ценный интеллектуальный актив компании. Накопленные знания остаются доступными внутри организации в любое время, исключая потерю экспертизы при смене ключевых сотрудников или кадровых перестановках.
При проектировании отказоустойчивых систем класса Enterprise стандартного подхода к Retrieval-Augmented Generation недостаточно. Архитектура корпоративного уровня строится с учетом высокой нагрузки, масштабируемости и построгого соблюдения регламентов информационной безопасности. Основной упор делается на создание отказоустойчивых конвейеров данных (ETL) и гибридный поиск, сочетающий лексическое совпадение (BM25) и векторное семантическое соответствие.
Ключевые инженерные решения в Enterprise RAG include:
Современные корпоративные знания редко ограничиваются чистым текстом. Чертежи, сканы договоров, финансовые графики, презентации и технические схемы содержат критически важную информацию. Multimodal RAG решает задачу извлечения и связывания данных из визуальных и текстовых источников одновременно.
Для работы с мультимодальными данными применяются следующие подходы:
Выбор генеративного ядра системы — ключевой этап разработки, определяющий итоговую стоимость, скорость отклика и степень защищенности коммерческой тайны. Облачные сервисы (например, OpenAI API, Anthropic Claude) предлагают максимально высокую точность понимания контекста из коробки, однако создают риски утечки данных во внешние контуры.
Локальные open-source модели (Llama 3, Mistral, Qwen), развернутые on-premise на собственных GPU-серверах компании, гарантируют полный контроль над контуром безопасности. Private RAG на базе локальных LLM исключает передачу sensitive-информации третьим лицам и позволяет гибко дообучать модели под узкоспециализированную терминологию отрасли, хотя и требует больше аппаратных ресурсов при внедрении.
Выберите тип задачи, расскажите о ней, каким вы видите решение и результат:
ИП Липаткин Павел Евгеньевич ИНН 661224380098 ОГРНИП 325665800174229