Без выходных: 9:30–20:00
Автоматическая сортировка и распределение потоков текстов
Точный поиск ключевых параметров и данных в документации
Определение эмоциональной окраски текстовых сообщений
Автоматическое создание логичных и корректных ответов
Делимся примерами проектов, где SEO, разработка и комплексный подход приносят измеримый рост трафика, заявок и продаж.
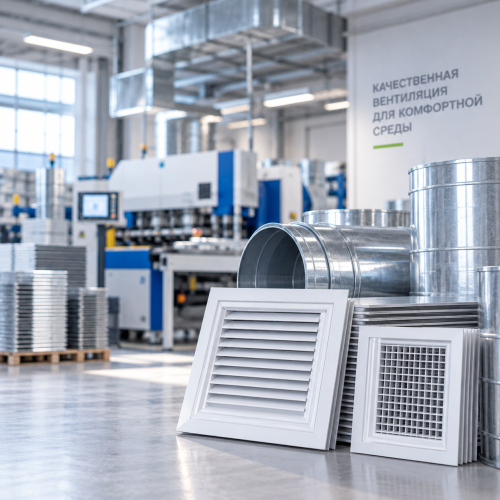
Все кейсыКомплексно оптимизировали интернет-магазин вентиляционных решеток и увеличили поисковый трафик с 2,7 до 11,2 тыс. визитов в месяц
Начало работ: май 2025
Тематика: Вентиляция, Производство.
Услуги: SEO-продвижение
Результат: х4 трафик из поисковых систем
Разработали сайт, расширили семантику и поисковую видимость — органический трафик вырос с нуля до 19,3 тыс. визитов в месяц
Разработка и SEO продвижение сайта грузоперевозок: сформировали стабильный органический трафик — первые 100+ посетителей из поисковых систем в день.
Оставьте заявку — обсудим задачу и подберём решение под ваш бизнес.
Услуга охватывает полный спектр технических работ: от первичной подготовки текстовых данных до встраивания алгоритмов в клиентскую инфраструктуру. Исполнитель выполняет настройку токенизации, обучает нейросетевые модели классификации, разворачивает системы extraction-анализа сущностей и векторного поиска embeddings, обеспечивая готовность сервиса к эксплуатации.
Исполнитель выполняет очистку исходных текстовых данных, проводит токенизацию и удаление шума. Производится ручная и полуавтоматическая разметка корпуса текстов, создание структурированных датасетов и формирование обучающих выборок, необходимых для корректной работы алгоритмов.
Разработка сайтов, SEO-продвижение и внедрение AI-решений для бизнеса.
Senior Web Developer · SEO · AI
Процесс создания интеллектуальной системы построек на поэтапном движении от анализа исходных данных до развертывания модели. Каждая стадия логически вытекает из предыдущей: сформированные датасеты определяют выбор архитектуры, обучение переходит в тестирование метрик, а валидированная модель встраивается в инфраструктуру с последующим сопровождением.
На старте проводится исследование бизнес-процессов и анализ имеющихся текстовых корпусов заказчика. Специалисты изучать структуры документов и проверяют полноту информации, чтобы оценить техническую осуществимость проекта и составить точный план дальнейшей разработки NLP-решения.
На основе результатов аудита формируется техническая концепция будущей системы. Команда подбирает оптимальные технологии natural language processing, определяя структуру пайплайнов обработки языка и способы взаимодействия составляющих модулей под задачи конкретного бизнеса.
Следующим шагом выполняется сборка обучающих материалов. Исходные тексты проходят очистку от шума, нормализацию и токенизацию. Затем осуществляется качественная разметка данных, без которой невозможно провести эффективное обучение алгоритмов машинного обучения.
Под подготовленный датасет подбираются наиболее подходящие предобученные языковые модели. Инженеры определяют архитектурную основу системы, оценивая параметры кандидатов и их способность эффективно решать заданные задачи с учетом имеющихся ресурсов.
Выбранные NLP-модели адаптируются под специфику предметной области компании. В процессе fine-tuning алгоритмы обучаются распознавать узкоспециализированную терминологию, формировать точные embeddings и демонстрировать глубокое понимание контекста и языка.
Обученное решение отправляется на этап комплексной валидации. Оценка качества выполняется на контрольных выборках с замером целевых метрик Precision, Recall и F1-score, что позволяет убедиться в точности классификации и извлечения данных перед запуском.
После успешных тестов готовый модуль переносится в рабочее окружение заказчика. Выполняется настройка API и интеграция с корпоративными сервисами, в результате чего система обработки документов начинает функционировать в реальных эксплуатационных условиях.
На заключительном этапе организуется непрерывный контроль работы сервиса. Инженеры отслеживают качество обработки естественного языка в реальном времени и регулярно обновляют модель на свежих данных для сохранения высокой точности при изменениях.
Внедрение NLP становится необходимостью, когда ежедневный поток текстовой информации выбывает из-под контроля, а ручная обработка документов и писем замедляет рабочие процессы. Стандартные методы управления контентом перестают справляться с высокой нагрузкой, вызывая задержки в операциях и рост издержек. Интеллектуальные NLP-решения выступают логичным шагом для перевода работы с языком на автоматические рельсы.
При непрерывном росте количества входящих писем, заявок и договоров сотрудники перегружаются рутинным чтением и анализом текста. Человеческий ресурс ограничен, из-за чего возникают критические задержки при обработке информации и увеличивается число досадных ошибок. Ручная проверка каждого файла требует слишком много времени и сил. В такой ситуации внедрение систем обработки естественного языка позволяет автоматизировать разбор документов и моментально находить ключевые смыслы.
Содержание штата первой линии поддержки только для первичного чтения и перенаправления тикетов по отделам создает неоправданно высокую нагрузку на бюджет. Обычные скрипты не способны уловить тонкости контекста, что приводит к ошибочному распределению задач и затягиванию ответов клиентам. Разработка NLP для бизнеса дает возможность автоматически выявлять тематику сообщений и мгновенно направлять их нужным специалистам, сокращая операционные расходы.
Компания собирает тысячи отзывов, комментариев и обращений на разных площадках, однако не имеет возможности детально изучить весь этот объём информации. Без автоматизированных инструментов ручной анализ тональности и мнений становится невозможным, а скрытые претензии или запросы клиентов остаются незамеченными. Алгоритмы понимания языка обеспечивают глубокое извлечение данных, превращая хаотичную обратную связь в понятную аналитику для принятия решений.
Оценим рынок, конкурентов и потенциал
Подберём оптимальные каналы и инструменты
Покажем реальные ожидаемые результаты
Составим пошаговый план сроки и бюджет
Покажем, как работаем на реальных кейсах
Делимся опытом и результатами
Внедрение технологий обработки естественного языка трансформирует работу с текстовой информацией в компании. За счет глубокой автоматизации рутины бизнес кратно сокращает время обработки документов, исключает человеческий фактор и получает ценную аналитику. Происходит существенное снижение операционных расходов и рост качества клиентского сервиса.
Автоматическое считывание, распознавание смыслов и распределение входящих документов или сообщений происходит за секунды. Бизнес получает мгновенный разбор входящего потока данных без задержек и ожидания, что существенно повышает оперативность выполнения ключевых рабочих процессов.
Оптимизация расходов достигается благодаря передаче механических задач по сортировке, ручному вводу и сверке текстов алгоритмам. Сотрудники освобождаются от монотонной нагрузки, а компания сокращает операционные издержки и перенаправляет ценные ресурсы на стратегические задачи.
Автоматизированное распознавание ключевых условий, реквизитов и значений из документов полностью устраняет ошибки, вызванные усталостью или невнимательностью персонала. Предприятие получает гарантированно точные данные для принятия решений и корректного ведения баз.
Трансформация разрозненных отзывов и сообщений клиентов в структурированные отчеты дает объективное понимание их реального настроения. Компания получает ясные ориентиры для улучшения продукта, выявления проблемных зон и оперативного реагирования на негативные тренды.
Интеллектуальная система легко справляется с кратным ростом объема входящей информации и документов без расширения штата операторов. Бизнес сохраняет устойчивость и стабильное качество работы даже в periods пиковых нагрузок и сезонного роста активности.
Высокая скорость обработки запросов и точность ответов формируют новый уровень клиентского сервиса. Заказчики получают решения своих вопросов без долгих ожиданий, что напрямую увеличивает их лояльность, укрепляет репутацию бренда и выгодно выделяет компанию на рынке.
Технологии natural language processing трансформируют традиционные процессы, переводя работу со сложными массивами информации на принципиально иной уровень efficiency. Ключевая ценность заключается в способности ИИ учитывать специфический отраслевой контекст и правила. В зависимости от сферы внедрение NLP решает узкоспециализированные задачи:
Создание отказоустойчивых сервисов требует гибкого комбинирования фундаментальных алгоритмов и современной инфраструктуры. В зависимости от требований к задержке (latency) и приватности мы подбираем оптимальные библиотеки, фреймворки и аппаратные мощности.
Базовый уровень подготовки текстов включает специализированную токенизацию, лемматизацию и выделение стоп-слов с помощью библиотек spaCy, NLTK и Stanza. Для задач векторизации и генерации контекстных embeddings используются глубокие архитектуры на базе PyTorch и TensorFlow, а также готовые веса моделей из экосистемы Hugging Face Transformers.
Высокая скорость работы и масштабируемость обеспечиваются микросервисной архитектурой: модели оборачиваются в FastAPI/GRPC контейнеры и разворачиваются в Kubernetes с аппаратным ускорением на базе NVIDIA CUDA.
Развитие индустрии обработка естественного языка смещается в сторону мультимодальности и локальной автономности. Современные LLM выходят за рамки простого анализа текста — они способны одновременно обрабатывать аудиопотоки, изображения и табличные структуры данных, сохраняя единую контекстную цепочку.
Параллельно растет тренд на квантование и дистилляцию: компактные специализированные модели (Small Language Models) обучаются работать локально на инфраструктуре заказчика без потери качества понимания языка. Это гарантирует полную независимость от внешних вендоров, абсолютную безопасность коммерческой тайны и минимальное энергопотребление при обработке миллионных потоков документов.
Выберите тип задачи, расскажите о ней, каким вы видите решение и результат:
ИП Липаткин Павел Евгеньевич ИНН 661224380098 ОГРНИП 325665800174229