Без выходных: 9:30–20:00
Разработка решений от стандартных ML до сложных LLM моделей.
Точная настройка параметров и весов под метрики вашего бизнеса.
Оптимизация работы сервиса для стабильной обработки запросов.
Установка и работа готовой системы в вашем закрытом контуре.
Делимся примерами проектов, где SEO, разработка и комплексный подход приносят измеримый рост трафика, заявок и продаж.
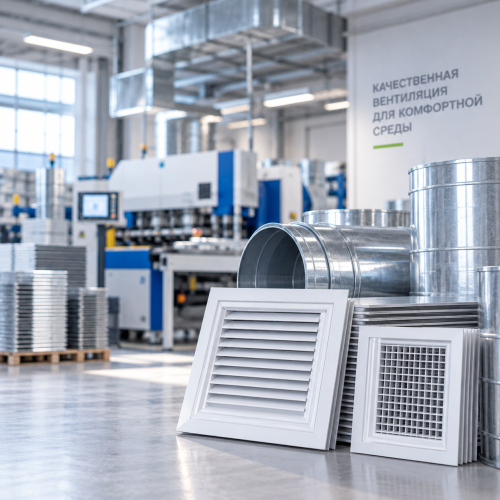
Все кейсыКомплексно оптимизировали интернет-магазин вентиляционных решеток и увеличили поисковый трафик с 2,7 до 11,2 тыс. визитов в месяц
Начало работ: май 2025
Тематика: Вентиляция, Производство.
Услуги: SEO-продвижение
Результат: х4 трафик из поисковых систем
Разработали сайт, расширили семантику и поисковую видимость — органический трафик вырос с нуля до 19,3 тыс. визитов в месяц
Разработка и SEO продвижение сайта грузоперевозок: сформировали стабильный органический трафик — первые 100+ посетителей из поисковых систем в день.
Оставьте заявку — обсудим задачу и подберём решение под ваш бизнес.
Услуга включает комплексный цикл инженерных и исследовательских работ: от аналитической оценки задач до развертывания готовой системы. Мы выполняем проектирование архитектуры, сбор и очистку датасетов, тонкую настройку параметров, математическую валидацию, а также техническую оптимизацию алгоритмов для бесшовной интеграции моделей в вашу IT-инфраструктуру.
Определяем класс модели, выбираем оптимальную нейросетевую архитектуру и проверяем целесообразность использования open-source или проприетарных решений. Рассчитываем вычислительные мощности, необходимые для обучения и запуска, подбираем параметры под требования бизнеса.
Разработка сайтов, SEO-продвижение и внедрение AI-решений для бизнеса.
Senior Web Developer · SEO · AI
Создание нейросетевых решений проходит по четко структурированному марштуру. Процесс начинается с глубокого анализа задач и данных, продолжается поэтапным проектированием и проверкой гипотез, переходит к обучению алгоритмов и завершается их развертыванием в инфраструктуре заказчика с последующим пострелизным сопровождением.
Первый этап включает формулирование требований к ИИ-системе, определение ключевых показателей успеха и оценку имеющихся данных. Специалисты анализируют целесообразность применения искусственного интеллекта для решения вашей бизнес-задачи и составляют карту рисков.
На этом шаге подбирается базовая архитектура модели и формируется стек технологий. Команда составляет подробное техническое задание, где фиксируются все параметры будущей системы и целевые метрики качества, необходимые для старта разработки.
Процесс продолжается подготовкой обучающей выборки. На этом этапе происходит сбор, очистка данных от шума, их нормализация и разметка, что создает надежный фундамент для корректного обучения выбранных алгоритмов.
Для снижения рисков создается Proof of Concept — тестовая версия модели на ограниченном наборе данных. Это позволяет быстро оценить жизнеспособность выбранного подхода и подтвердить возможность достижения заявленных показателей.
После успешной проверки начинается полномасштабное обучение модели на полном датасете. Инженеры подбирают гиперпараметры и оптимизируют веса нейросети, добиваясь максимальной точности работы алгоритмов.
Обученная модель проходит всестороннюю проверку на контрольных выборках. Проводится детальный анализ ошибок и проверка работы на редких крайних случаях (edge cases) для соответствия установленным требованиям.
На этапе deployment готовая модель упаковывается в изолированные контейнеры и развертывается на локальных серверах или в облаке. Настраиваются интерфейсы API для стабильного выполнения запросов (inference).
Завершающий этап включает отслеживание работы системы в реальном времени. Специалисты контролируют показатели, предотвращают деградацию качества (data drift) и проводят периодическое дообучение модели на новых данных.
Применение готовых нейросетей часто сталкивается с жесткими ограничениями по стоимости, точности и безопасности. Когда бизнес масштабируется, внешние API становятся причиной неконтролируемых расходов, а коробочные алгоритмы не способны учесть узкую отраслевую специфику. Индивидуальная разработка AI-моделей становится необходимой, если компании требуется полный контроль над процессами, защищенная инфраструктура и максимальная точность вычислений.
При интенсивном использовании облачных сторонних сервисов и постоянном росте количества токенов затраты на интеграцию становятся экономически нецелесообразными. Подписочные модели и оплата за каждый отдельный запрос создают высокую финансовую нагрузку при масштабировании продуктов. Кастомная разработка AI-моделей позволяет перенести вычисления на собственную инфраструктуру компании, снижая удельную стоимость inference и обеспечивая прогнозируемый бюджет.
Универсальные решения не справляются с глубоким контекстом специализированных отраслей, допускают критические ошибки в терминах или дают высокую погрешность. Попытки решить проблему с помощью стандартных промптов не обеспечивают требуемого уровня точности в обработке информации. Для решения узкопрофильных задач актуальным становится fine-tuning существующей архитектуры или обучение оригинальной AI-модели с нуля на целевом датасете бизнеса.
Регуляторные ограничения и внутренние политики безопасности запрещают передачу персональной или коммерческой информации на сторонние зарубежные серверы. Базовые облачные ИИ-сервисы не удовлетворяют корпоративным стандартам конфиденциальности финтеха, медицины и ритейла. В этой ситуации становится критически необходимой разработка кастомной AI-модели с последующим развертыванием в закрытом локальном контуре предприятия.
Оценим рынок, конкурентов и потенциал
Подберём оптимальные каналы и инструменты
Покажем реальные ожидаемые результаты
Составим пошаговый план сроки и бюджет
Покажем, как работаем на реальных кейсах
Делимся опытом и результатами
Внедрение собственной модели ИИ трансформирует ключевые процессы компании, превращая цифровые данные в реальные рыночные преимущества. Бизнес получает полную независимость от внешних сервисов, устойчивую экономию бюджета при масштабировании, максимальную защиту информации и существенный прирост скорости обработки операций без потери качества.
Бизнес получает кратное ускорение обработки данных: анализ сложных текстов, классификация графики и принятие решений занимают доли секунды вместо десятков минут человеческой работы. Это позволяет обслуживать значительно больший поток клиентов и моментально реагировать на изменение рыночной ситуации.
Отказ от постоянных вызовов платных внешних API и автоматизация рутинных задач позволяют кардинально сократить издержки. Вы больше не платите за каждый токен или запрос сторонним сервис-провайдерам, а используете собственную эффективную инфраструктуру с прозрачной и предсказуемой стоимостью.
Развертывание системы внутри вашего закрытого контура гарантирует абсолютную защищенность коммерческих данных и сведений о клиентах. Чувствительная информация больше не передается на сторонние серверы, что полностью исключает утечки и соответствие требованиям самых строгих корпоративных стандартов.
Компания приобретает умного помощника, обученного исключительно на её спецификациях, документах и отраслевом лексиконе. В отличие от универсальных систем, профильный алгоритм обеспечивает минимальный уровень ошибок и принимает решения с учётом всех тонкостей ваших внутренних бизнес-процессов.
Собственные интеллектуальные алгоритмы становятся ценным нематериальным активом, недоступным вашим прямым конкурентам. Это позволяет создавать эксклюзивные продукты, запускать уникальные сервисы для пользователей и занимать лидирующие позиции на рынке за счет более высокого качества сервиса.
Компания освобождается от ограничений сторонних платформ по количеству запросов в минуту или объёму файлов. Собственное решение позволяет свободно наращивать мощности под растущие потребности бизнеса, гарантируя стабильную работу инфраструктуры даже при пиковых нагрузках.
Выбор архитектуры зависит от специфики решаемой задачи, характера входных данных и формата ожидаемого результата. В рамках инжиниринга создаются как специализированные математические алгоритмы, так и глубокие нейросетевые системы:
Эффективность работы модели в боевом окружении определяется не только точностью, но и скоростью генерации ответов (inference), а также потреблением железа. Для снижения аппаратных требований и сокращения задержек применяется комплекс инженерных методик optimization. Квантование (quantization) позволяет перевести веса модели из FP16 или FP32 в 8-битный или 4-битный формат без ощутимой потери точности. Дистилляция переносит знания из тяжеловесной архитектуры в компактный нейронный модуль. В сочетании с прунингом некритичных связей и использованием специализированных движков исполнения это снижает затраты на облачную GPU-инфраструктуру в 3–5 раз.
Передача чувствительной корпоративной информации во внешние облачные сервисы создает критические риски утечки коммерческой тайны и нарушения требований регуляторов. Развертывание в изолированном контуре (On-premise Deployment) полностью устраняет эту проблему.
Галлюцинации в генеративных сетях возникают из-за вероятностной природы предсказания следующих токенов и недостатка фактологических данных в процессе первоначального обучения. Для исключения недостоверных ответов внедряется методология RAG (Retrieval-Augmented Generation), которая заставляет модель опираться исключительно на верифицированную базовую базу знаний.
Тестирование качества проводится по двум направлениям: формальные автоматизированные метрики (BLEU, ROUGE, perplexity) и сценарии с привлечением профильных асессоров (RLHF). Такой подход устраняет предвзятость алгоритмов, гарантирует корректную работу с краевыми случаями (edge cases) и обеспечивает строгую предсказуемость логики системы.
Выберите тип задачи, расскажите о ней, каким вы видите решение и результат:
ИП Липаткин Павел Евгеньевич ИНН 661224380098 ОГРНИП 325665800174229