Без выходных: 9:30–20:00
Автоматическая обработка PDF, фото и сканов документов
Интеллектуальное распознавание паспортов, счетов и актов
Автоматическая проверка данных и оценка уверенности ИИ
Бесшовное подключение к вашим системам 1С, CRM и ERP
Делимся примерами проектов, где SEO, разработка и комплексный подход приносят измеримый рост трафика, заявок и продаж.
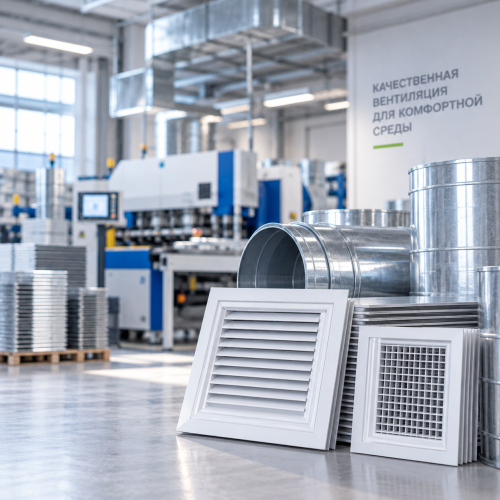
Все кейсыКомплексно оптимизировали интернет-магазин вентиляционных решеток и увеличили поисковый трафик с 2,7 до 11,2 тыс. визитов в месяц
Начало работ: май 2025
Тематика: Вентиляция, Производство.
Услуги: SEO-продвижение
Результат: х4 трафик из поисковых систем
Разработали сайт, расширили семантику и поисковую видимость — органический трафик вырос с нуля до 19,3 тыс. визитов в месяц
Разработка и SEO продвижение сайта грузоперевозок: сформировали стабильный органический трафик — первые 100+ посетителей из поисковых систем в день.
Оставьте заявку — обсудим задачу и подберём решение под ваш бизнес.
Разработка включает полный комплекс программных модулей для автоматической обработки входящей документации. Мы создаем алгоритмы предварительной подготовки файлов, системы классификации, движки оптического считывания текста и блоки NLP-анализа, а также настраиваем механизмы валидации реквизитов и программные API-шлюзы для интеграции с корпоративной ИТ-инфраструктурой.
Создаем программные алгоритмы для автоматической подготовки входящих сканов и фотографий к OCR-обработке. Реализуем функции кадрирования, удаления внешних шумов, выравнивания уголков и перекосов, нейтрализации бликов и теней, а также бинаризации изображений для обеспечения максимальной точности считывания.
Разработка сайтов, SEO-продвижение и внедрение AI-решений для бизнеса.
Senior Web Developer · SEO · AI
Процесс реализации проекта построек как последовательный маршрут: от глубинного анализа текущих операций и подготовки данных до обучении алгоритмов, их точной настройки и безопасной интеграции. Каждая стадия логически вытекает из предыдущей, обеспечивая контролируемый переход от обследования к работающему сервису.
Работа начинается с обследования действующего документооборота компании. Оцениваются входящие потоки, выявляются наиболее узкие места и систематизируются типы файлов, подлежащие автоматической обработке. Результатом этапа становятся зафиксированные критерии точности и целевые показатели скорости.
На основе собранных материалов формируется репрезентативная выборка образцов. Специалисты выполняют обезличивание чувствительной информации, после чего размечают ключевые поля и реквизиты на сканах, фото и PDF для корректной подготовки обучающей среды нейронных сетей.
После подготовки данных проектируется техническая база решения. Проводится подбор специализированных движков OCR и архитектур машинного обучения, способных одинаково эффективно классифицировать и извлекать данные как из жестко заданных шаблонов, так и из неструктурированных файлов.
Отобранные модели проходят процедуру глубокого обучения на подготовленном наборе данных. Алгоритмы тренируются уверенно распознавать спецификацию оригиналов, сложные шрифты, таблицы и контекстное окружение, добиваясь максимально высоких метрик точности.
Сформированные модели дополняются модулями пост-обработки. Настраиваются правила сверки найденных полей по корпоративным справочникам и математическим формулам, а также задаются пороги уверенности алгоритма для передачи сложных случаев операторам.
Готовый модуль распознавания связывается с рабочей ИТ-инфраструктурой. Разрабатывается программный интерфейс для автоматического приема входящих изображений и моментальной отдачи структурированного текста прямо в корпоративные учетные системы.
Система запускается в тестовую эксплуатацию на реальном потоке информации под контролем специалистов. На этом этапе выявляются редкие краевые случаи, устраняются неточности и проводится финальная калибровка алгоритмов извлечения полей.
Разработанный сервис окончательно разворачивается в рабочем контуре компании. Персонал проходит инструктаж по работе с интерфейсом проверки, а система переводится на постоянный мониторинг с возможностью регулярного дообучения моделей.
Внедрение интеллектуального распознавания документов становится актуальным, когда объем входящей документации перегружает бэк-офис, а ручная обработка данных перестает справляться с масштабированием бизнеса. Если ошибки ввода становятся регулярными, а сотрудники тратят всё время на перенос данных из сканов в систему, ИИ-решение поможет устранить «бутылочное горлышко» и перевести процессы в автоматический режим.
В периоды пиковых нагрузок или при масштабировании продаж бухгалтерия и отделы обработки данных перегружены ручным вводом актов, счетов и накладных. Традиционные методы требуют найма новых операторов, что увеличивает затраты, но не гарантирует скорости. Система распознавания документов с ИИ снимает рутину, мгновенно оцифровывая входящие файлы и передавая структурированные данные в учетную систему, что исключает очереди и задержки в оплатах.
Человеческий фактор при переносе реквизитов, сумм или дат из документов неизбежно приводит к опечаткам, что влечет за собой финансовые потери, претензии налоговой и юридические риски. Когда цена ошибки становится критичной, требуется автоматизированный контроль качества. Внедрение ИИ обеспечивает высокую точность извлечения и автоматическую валидацию данных, предотвращая попадание некорректной информации в базу и защищая бизнес от последствий ручных ошибок.
В банковском секторе, страховании или каршеринге скорость онбординга напрямую влияет на конверсию и лояльность. Длительное ожидание, пока оператор вручную перепечатает данные паспорта или прав, вызывает раздражение пользователей и увеличивает стоимость привлечения. Автоматическое распознавание полей позволяет мгновенно верифицировать личность клиента в момент подачи заявки, ускоряя обслуживание и высвобождая время сотрудников для задач, требующих экспертной оценки.
Оценим рынок, конкурентов и потенциал
Подберём оптимальные каналы и инструменты
Покажем реальные ожидаемые результаты
Составим пошаговый план сроки и бюджет
Покажем, как работаем на реальных кейсах
Делимся опытом и результатами
Интеграция интеллектуальной системы обработки документов трансформирует работу бэк-офиса, освобождая компанию от рутины. Вы получаете максимальную точность ввода данных, кратное ускорение ключевых бизнес-процессов и существенную экономию ресурсов. Автоматизация снижает влияние человеческого фактора и подготавливает инфраструктуру к безопасному масштабированию.
Мгновенный ввод данных из файлов любого формата ускоряет проведение платежей, регистрацию контрагентов и отгрузку товаров. Вся информация из входящих PDF и сканов попадает в учетную систему за считаные секунды, что полностью исключает задержки и очереди на этапе обработки первички.
Оптимизация рутинных операций позволяет компании расти без расширения штата операторов ввода. Автоматическая обработка шаблонных документов освобождает сотрудников от монотонного труда, перенаправляя их время на решение аналитических и профильных задач.
Высокая точность алгоритмов и автоматическая проверка извлеченных реквизитов устраняют опечатки, связанные с человеческим фактором. Это предотвращает юридические риски, неверные финансовые проводки и возможные штрафы, обеспечивая безупречную чистоту корпоративных баз данных.
Автоматическое считывание сведений из паспортов и удостоверений повышает скорость оформления услуг, выдачи займов или пропусков. Быстрая проверка данных повышает удовлетворенность клиентов, снижает время ожидания и положительно влияет на конверсию в успешную сделку.
Перевод бумажных артефактов и договоров в полнотекстовый цифровой формат упрощает аудит, поиск и аналитику. Руководство получает полный контроль над входящим потоком информации, исключая риск потери оригиналов и ускоряя согласование внутренних документов.
Инфраструктура без проблем справляется с резкими пиковыми нагрузками в конце отчетных периодов. Предприятие может увеличивать объем обрабатываемых накладных, актов и счетов в разы, не сталкиваясь с просадкой по скорости или пропускной способности системы.
Современное нейросетевое распознавание документов вышло далеко за рамки классических гибридных систем OCR. Для построения высокоточных пайплайнов класса IDP (Intelligent Document Processing) мы комбинируем компьютерное зрение и архитектуры глубокого обучения. Первичную сегментацию и детекцию графических блоков выполняют модели на базе YOLOv8 и Mask R-CNN, а непосредственный перевод графических пикселей в символы обеспечивают специализированные CRNN (Convolutional Recurrent Neural Networks) с механизмами внимания (Attention Mechanisms) и Transformer-архитектуры.
Работа с содержанием и смысловым контекстом строится на базе специализированных моделей естественного языка (NLP) уровня BERT и RoBERTa. Они обеспечивают интеллектуальный text recognition и автоматическую извлекаемость связей между полями:
Распознавание рукописного текста (HTR — Handwritten Text Recognition) считается наиболее сложной задачей в сфере оцифровки. В отличие от стандартных типографских шрифтов, где символы имеют стабильную геометрию и высоту, ручной ввод отличается нелинейной траекторией строк, различным наклоном букв, разной степенью нажатия и непрерывным связным написанием нескольких знаков подряд.
Чтобы обеспечить высокую точность извлечения информации из заполненных вручную бланков, заявлений и анкет, мы применяем специализированный алгоритмический подход:
Вычислительные ресурсы для разработки системы распознавания документов и её работы зависят от характера нагрузки, требуемой скорости (Real-Time или Batch-обработка) и выбранного метода развертывания. При обработке документов в изолированном контуре предприятия (On-Premise) серверное оборудование выполняет операции как на CPU, так и на специализированных графических ускорителях GPU.
Для обеспечения стабильной работы document AI решения рекомендуются следующие аппаратные характеристики:
Традиционные классические системы оптического распознавания опираются на жесткую координатную привязку (Zonal OCR). Они работают исключительно с фиксированными шаблонами: алгоритму строго указывается, в каком конкретном месте листа находится ИНН или дата. Если контрагент изменит шрифт, сместит логотип или добавит лишнюю строчку в таблицу, шаблонный подход выдает ошибку либо считывает нерелевантные данные.
Интеллектуальное нейросетевое распознавание документов адаптируется к любой структуре данных за счет смыслового анализа листа:
Выберите тип задачи, расскажите о ней, каким вы видите решение и результат:
ИП Липаткин Павел Евгеньевич ИНН 661224380098 ОГРНИП 325665800174229