Без выходных: 9:30–20:00
Автоматическое распределение входящих данных по категориям
Удаление дубликатов и быстрое исправление ошибок в записях
Поиск и выделение ключевых сущностей из любого текста
Дополнение профилей записей информацией из внешних систем
Делимся примерами проектов, где SEO, разработка и комплексный подход приносят измеримый рост трафика, заявок и продаж.
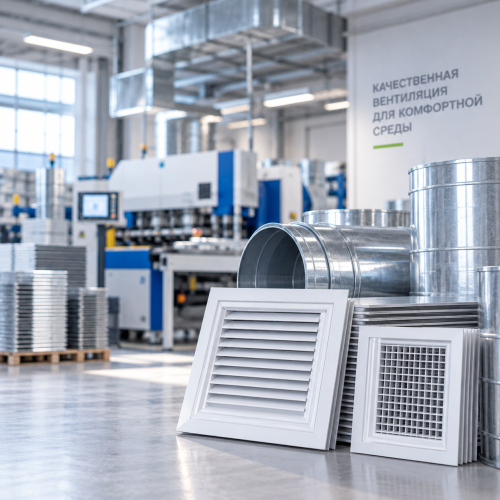
Все кейсыКомплексно оптимизировали интернет-магазин вентиляционных решеток и увеличили поисковый трафик с 2,7 до 11,2 тыс. визитов в месяц
Начало работ: май 2025
Тематика: Вентиляция, Производство.
Услуги: SEO-продвижение
Результат: х4 трафик из поисковых систем
Разработали сайт, расширили семантику и поисковую видимость — органический трафик вырос с нуля до 19,3 тыс. визитов в месяц
Разработка и SEO продвижение сайта грузоперевозок: сформировали стабильный органический трафик — первые 100+ посетителей из поисковых систем в день.
Оставьте заявку — обсудим задачу и подберём решение под ваш бизнес.
В рамках услуги выполняется комплексная разработка AI-системы обработки данных, включающая настройку модулей для автоматического разбора входящих потоков, очистки корпоративных баз, извлечения ключевых сведений из текстов и приведения информации к единым стандартам. Наш подход охватывает все направления data processing для превращения сырых массивов в структурированные датасеты.
Создаем и настраиваем ИИ-модели для автоматического распределения входящих потоков информации по заданным рубрикам. Алгоритмы выполняют интеллектуальную обработку данных, обеспечивая сортировку файлов, писем или сканов по типам и их точную маршрутизацию в соответствующие отделы без участия сотрудников.
Разработка сайтов, SEO-продвижение и внедрение AI-решений для бизнеса.
Senior Web Developer · SEO · AI
Создание AI data processing проходит по поэтапной траектории: от первичного исследования бизнес-процессов до интеграции готового решения. Мы пошагово анализируем задачи, подготавливаем информацию, тренируем нейросети и аккуратно встраиваем алгоритмы в вашу систему. После успешного запуска мы обеспечиваем регулярный мониторинг и постепенное расширение возможностей созданной инфраструктуры.
На старте мы глубоко изучаем текущие бизнес-процессы и инфраструктуру клиента. Проводится детальный анализ состояния корпоративных баз данных, форматов хранения и реальных объемов информации. Это необходимо для корректного выбора архитектуры ИИ и эффективной обработки больших данных с ИИ.
На этом этапе мы формируем подробное техническое задание и подбираем оптимальные алгоритмы машинного обучения. Специалисты проектируют надежные пайплайны передачи информации и планируют способы связи с текущими системами заказчика для бесшовного выполнения разработки AI-системы обработки данных.
Команда осуществляет сбор, очистку и качественную разметку исторических данных заказчика, которые потребуются для обучения нейросетей. Качественная обработка полей, записей и документов на этой стадии напрямую гарантирует высокую точность работы будущей интеллектуальной системы.
Технический шаг, на котором алгоритмы машинного обучения тренируются на подготовленной выборке. Мы проводим точечную настройку параметров под задачи классификации, извлечения и нормализации для достижения максимально возможных показателей точности и скорости работы системы.
Обученные модели проходят тщательную проверку на контрольных выборках. Мы фиксируем и исправляем ошибки распознавания, осуществляем контроль качества и корректируем алгоритмы, чтобы интеллектуальная обработка данных полностью соответствовала установленным бизнес-показателям.
Готовый AI-инструмент подключается к текущей IT-инфраструктуре клиента, включая CRM, ERP и корпоративные хранилища данных. Настройка обмена по API гарантирует, что автоматизация обработки данных с ИИ происходит незаметно для пользователей и в режиме реального времени.
Решение запускается в ограниченном режиме на реальном потоке информации. В процессе пилотной эксплуатации мы собираем обратную связь от пользователей, отслеживаем нагрузку на серверы и проводим финальную калибровку правил, которыми руководствуется автоматическая обработка.
Проект переводится в полномасштабный рабочий режим на весь объем операций. Мы организуем непрерывный мониторинг работы нейросетей, их регулярное дообучение при поступлении новых типов данных и гарантийное обслуживание для стабильного AI data processing.
Компании сталкиваются с ситуацией, когда традиционные методы работы с информацией становятся узким местом для бизнеса. Растущие массивы документов, задержки в обслуживании клиентурой и постоянные ошибки сотрудников ведут к прямым убыткам. Когда ручной ввод затягивает процессы, а аналитики не могут доверить отчетам из-за ошибок в базах, разработка AI-системы обработки данных становится единственным логичным шагом.
Бизнес быстро растет, и поток документов, логов или транзакций становится неподъемным для операторов. Накопление неразобранных файлов создает бэклоги, затягивает обработку заявок и приводит к потере клиентов. Ручное расширение штата лишь увеличивает издержки, не решая проблему скорости. В этой ситуации обработка больших данных с ИИ становится необходимым шагом, обеспечивая автоматическую обработку данных и мгновенный разбор входящих массивов в режиме реального времени.
Дубликаты записей, пропущенные поля и разрозненные форматы в базах данных приводят к искажению аналитики и принятию неверных управленческих решений. Попытки сотрудников вручную исправлять опечатки и сверять реестры требуют много времени и не гарантируют отсутствия ошибок. Ситуация требует перехода на интеллектуальный формат работы, где автоматическая очистка, нормализация и data processing устраняют хаос и возвращают высокое доверие к корпоративным отчетам.
Критически важная информация остаётся заблокированной внутри договоров, актов, сканов и разрозненных PDF-файлов. Специалисты вынуждены тратить часы на вычитку текстов и поиск нужных пунктов вместо выполнения своих прямых обязанностей. Традиционный текстовый поиск не справляется со сложными документами. Внедрение алгоритмов извлечения информации и классификации позволяет быстро находить ключевые факты и переводить неструктурированные тексты в базы данных.
Оценим рынок, конкурентов и потенциал
Подберём оптимальные каналы и инструменты
Покажем реальные ожидаемые результаты
Составим пошаговый план сроки и бюджет
Покажем, как работаем на реальных кейсах
Делимся опытом и результатами
Внедрение интеллектуальной обработки данных превращает хаотичные массивы информации в прозрачный стратегический ресурс. Компания приобретает устойчивую цифровую инфраструктуру, которая освобождает операционные бюджеты, исключает ошибки из-за человеческого фактора и ускоряет сквозные процессы. Вы получаете инструмент для мгновенного принятия обоснованных управленческих решений.
Время исполнения рутинных операций по разбору документов сокращается с нескольких рабочих дней до пары секунд. Автоматическая обработка массивов данных мгновенно классифицирует входящие потоки информации, устраняет задержки в обслуживании клиентов и повышает скорость работы смежных отделов.
Автоматизация обработки данных с ИИ позволяет перераспределить ресурсы компании и сократить затраты на ручной ввод. Предприятие экономит бюджет за счет оптимизации фонда оплаты труда и направляет штатных специалистов на решение приоритетных аналитических задач, окупая инвестиции в проект.
Непрерывный контроль качества, глубинная очистка и нормализация устраняют задублированные записи и критические опечатки. В распоряжении компании появляются доверенные реестры и справочники, гарантирующие абсолютную достоверность сведений во всех внутренних операциях.
Полноценное структурирование и систематическое обогащение данных открывают новые возможности для BI-систем. Руководители получают точную аналитическую отчетность без искажений, что позволяет находить скрытые точки роста бизнеса и оперативно реагировать на рыночные изменения.
Обработка больших данных с ИИ создает надежный фундамент для масштабирования компании. Архитектура легко справляется с многократным увеличением входящего потока информации без потери производительности и без необходимости пропорционального расширения штата операторов.
Точное извлечение информации и строгое сопоставление ключевых сущностей защищают бизнес от ошибок при оформлении документации. Автоматизированная сверка снижает вероятность штрафов от регуляторов, потери важной первичной отчетности и финансовых издержек из-за человеческого фактора.
Связка алгоритмов машинного обучения с существующей ИТ-инфраструктурой — критический этап, от которого зависит скорость доступа к информации. Внедрение модулей AI data processing реализуется через изолированные микросервисы и защищенные API-интерфейсы. Это позволяет интегрировать модели интеллектуального анализа без остановки текущих бизнес-процессов компании.
В зависимости от архитектуры заказчика мы организуем двусторонний обмен данными с различными типами корпоративных систем:
Точность работы нейросетевых моделей напрямую зависит от подготовленности исходных выборок. На этапе разработки AI-системы обработки данных уделяется особое внимание формированию эталонных датасетов. Присутствие аномалий, несбалансированных классов или ошибок в исходной разметке приводит к снижению метрик Precision и Recall.
Для достижения максимальной точности алгоритмов при работе с текстовыми и табличными данными вводятся следующие критерии качества:
Работа с высоконагруженными потоками (Stream Processing) требует использования специализированной архитектуры, способной принимать и анализировать информацию без задержек. В отличие от пакетной обработки (Batch Processing), потоковые алгоритмы распределяют входящие записи по категориям и извлекают сущности буквально на лету.
Для обеспечения отказоустойчивости при обработке больших объемов информации применяются брокеры сообщений (Apache Kafka, RabbitMQ) и распределенные вычислительные движки. Это гарантирует сохранение высокой скорости работы даже в моменты пиковых нагрузок на корпоративную сеть.
Выберите тип задачи, расскажите о ней, каким вы видите решение и результат:
ИП Липаткин Павел Евгеньевич ИНН 661224380098 ОГРНИП 325665800174229