Без выходных: 9:30–20:00
Подготовка и глубокая разметка данных компании
Использование LoRA и адаптеров для работы
Проверка качества и тестирование на бенчмарках
Настройка среды для стабильной работы модели
Делимся примерами проектов, где SEO, разработка и комплексный подход приносят измеримый рост трафика, заявок и продаж.
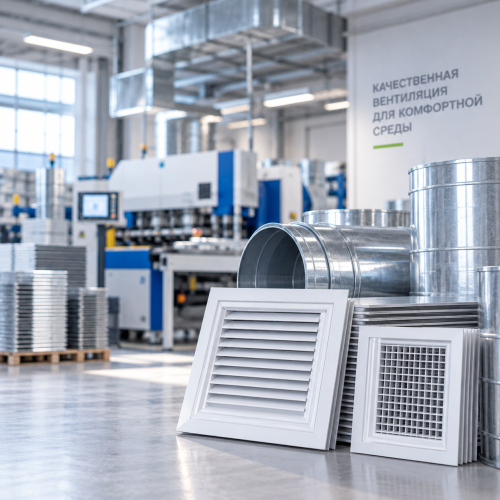
Все кейсыКомплексно оптимизировали интернет-магазин вентиляционных решеток и увеличили поисковый трафик с 2,7 до 11,2 тыс. визитов в месяц
Начало работ: май 2025
Тематика: Вентиляция, Производство.
Услуги: SEO-продвижение
Результат: х4 трафик из поисковых систем
Разработали сайт, расширили семантику и поисковую видимость — органический трафик вырос с нуля до 19,3 тыс. визитов в месяц
Разработка и SEO продвижение сайта грузоперевозок: сформировали стабильный органический трафик — первые 100+ посетителей из поисковых систем в день.
Оставьте заявку — обсудим задачу и подберём решение под ваш бизнес.
Наша услуга охватывает полный инженерный цикл адаптации искусственного интеллекта под требования заказчика. Мы выполняем стратегический аудит задач, готовим датасеты, настраиваем архитектуру и гиперпараметры, проводим обучение на мощных GPU-кластерах, проверяем метрики качества и разворачиваем оптимизированную модель в инфраструктуре вашего предприятия.
Проводим анализ предметной области и определяем требования к размеру, скорости и языковым возможностям модели. Подбираем оптимальную открытую или коммерческую нейросеть, такую как Llama или Mistral, исключая лишние расходы на избыточные вычислительные мощности.
Разработка сайтов, SEO-продвижение и внедрение AI-решений для бизнеса.
Senior Web Developer · SEO · AI
Процесс адаптации строится на предсказуемой методологии и разбит на логические итерации. Разработка начинается с аудита требований и подготовки данных, проходит через этапы тренировки и тщательного контроля метрик, а завершается оптимизацией и интеграцией готовую систему. Заказчик оценивает результаты на ключевых точках, что гарантирует точное соответствие итоговой модели задачам бизнеса.
На стартовой встрече собираются технические требования к точности, скорости работы и формату ответов. Фиксируются целевые метрики успеха, после чего согласуется подробное техническое задание на адаптацию модели под бизнес.
Проводится тестирование подходящих open-source решений под специфику проекта. Специалисты подбирают оптимальную нейросеть, которая послужит надежным фундаментальным каркасом для последующего дообучения ИИ.
Осуществляется извлечение корпоративной информации из систем клиента. Проводится парсинг документов, очистка текстов от конфиденциальных данных и персональных сведений с приведением всего массива к единому формату.
Формируется структурированный датасет из пар вопросов и ответов или специализированных инструкций. Разметчики подготавливают идеальные образцы для supervised fine-tuning, на которых будет обучаться алгоритм.
Запускается процедура тренировки с применением метода LoRA. Обновление весов происходит на уровне легких адаптеров без изменения базовой структуры, при этом инженер постоянно мониторит график функции потерь.
Первая версия модели тестируется на контрольной выборке. Эксперты анализируют ключевые метрики качества, выявляют возможные галлюцинации и при необходимости корректируют параметры для дообучения LLM.
Выполняется подготовка нейросети к промышленной эксплуатации. Применяются методы сжатия и квантования, чтобы ускорить инференс и снизить требования к вычислительной памяти без потери точности ответов.
Осуществляется финальный деплой нейросети на серверах заказчика. Настраиваются API-эндпоинты для взаимодействия с сервисами, передается документация и проводиться инструктаж команды клиента.
Стандартные нейросети и промпт-инжиниринг перестают справляться, когда задачи компании требуют строгого соблюдения внутренних регламентов, глубокого понимания узкой тематики или работы в закрытом контуре. В таких условиях использование базовых API ведет к перерасходу бюджета и росту ошибок. Дообучение AI-моделей становится естественным шагом для создания точного и экономичного ИИ-инструмента.
Для получения корректного результата приходится отправлять гигантские промпты с десятками примеров в каждом запросе. Постоянная передача длинного контекста расходует лимиты токенов, резко повышает стоимость инференса и замедляет время отклика сервиса. Промпт-инжиниринг исчерпывает свои возможности, когда требования к ответу растут. Проведение fine-tuning позволяет зафиксировать правила в весах модели, снизить затраты на API и ускорить обработку.
Универсальная нейросеть допускает критические ошибки в узкоспециализированных терминах, путает внутренние артикулы или неверно трактует нормативные документы компании. В сферах с высокой ответственностью цена такой ошибки слишком велика, а стандартная LLM не обладает глубоким контекстом вашей ниши. Запуск supervised fine-tuning на подготовленном датасете устраняет слепые зоны и гарантирует точное соблюдение профессиональных стандартов.
Правила безопасности или требования регуляторов запрещают отправку чувствительных коммерческих данных и персональных сведений во внешние облачные API. При этом стандартные локальные модели без донастройки не дают нужного качества работы. В этой ситуации необходимо взять open-source нейросеть и дообучить ее на собственных мощностях. Это обеспечивает полную независимость, защиту коммерческой тайны и высокий уровень точности.
Оценим рынок, конкурентов и потенциал
Подберём оптимальные каналы и инструменты
Покажем реальные ожидаемые результаты
Составим пошаговый план сроки и бюджет
Покажем, как работаем на реальных кейсах
Делимся опытом и результатами
Адаптация нейросетей трансформирует базовые алгоритмы в стратегический актив компании. Вы получаете существенное снижение операционных издержек на серверную инфраструктуру, ускорение обработки регулярных задач, строгую конфиденциальность данных и полную независимость от сторонних сервисов, что выводит продуктивность ключевых процессов на принципиально новый уровень.
Компания получает нейросеть, которая свободно ориентируется во внутреннем регламенте, номенклатуре и специфической документации. Модель исключает размытые формулировки, мгновенно генерируя точные ответы в полном соответствии с профессиональными стандартами вашего бизнеса.
Переход на компактную дообученную модель оптимизирует расходы на вычислительные мощности. Отпадает необходимость передавать громоздкие контексты и раздутые промпты, что кардинально сокращает затраты на токены и инфраструктуру при обработке высокого потока запросов.
Автоматическая классификация обращений, анализ сложных документов и генерация специфических материалов происходят за доли секунды. Это разгружает ключевых специалистов от рутины и ускоряет реакцию на запросы клиентов в несколько раз без потери качества.
Локальное развертывание модели внутри собственного защищенного контура полностью исключает риск утечки коммерческой тайны. Ваша конфиденциальная информация и персональные данные клиентов не передаются сторонним провайдерам и никогда не будут использованы для обучения чужих систем.
Алгоритм стабильно выдерживает заданный формат генерации, соблюдает тональность бренда и избегает фактических ошибок. Это создает надежную основу для автоматизации внешних коммуникаций и позволяет безбоязненно использовать ИИ в клиентских сервисах.
Наличие собственности на веса и адаптеры обученной модели защищает бизнес от изменений тарифов, внезапных блокировок или смены условий сторонних API. Вы получаете автономный цифровой инструмент, который принадлежит исключительно вашей компании и свободно развивается под новые цели.
Базовые языковые модели обладают колоссальным объемом общих знаний, но пасуют перед специфическими задачами конкретного предприятия. Наш практический опыт показывает: попытки заставить коробочную нейросеть понимать внутренние регламенты или юридические тонкости только лишь через промпт-инжиниринг быстро упираются в технологический потолок.
Дообучение ИИ позволяет модифицировать структуру связей модели под конкретную доменную область. В процессе адаптации нейросеть усваивает узкоотраслевой лексикон, начинает строго следовать заданному формату ответов и перестает генерировать правдоподобные, но ложные факты.
При выборе стратегии fine-tuning ключевым фактором становится баланс между точностью и вычислительными затратами. Полный Full Fine-Tuning требует модификации всех параметров LLM, что влечет за собой необходимость использования мощных GPU-кластеров и несет риск разрушения базовых языковых навыков модели.
Методы Parameter-Efficient Fine-Tuning (PEFT), в частности технология LoRA (Low-Rank Adaptation), решают эту проблему. Вместо переписи всей архитектуры мы замораживаем основные веса базовой модели и обучаем лишь компактные внешние адаптеры. Это сокращает потребление видеопамяти в 3–4 раза и ускоряет процесс тренировки без потери качества генерации.
Использование публичных облачных API создает критические риски для бизнеса: от утечки коммерческой тайны до нарушения законов о персональных данных. Передача конфиденциальной информации на сторонние сервера часто недопустима по соображениям службы безопасности.
Мы проектируем решения с учетом развертывания дообученной модели в изолированном контуре (on-premise) или в приватном облаке компании. После завершения этапа дообучения все веса и подготовленные датасеты остаются в собственности заказчика. Внешний доступ к закрытой инфраструктуре полностью исключается, что гарантирует абсолютную приватность бизнес-процессов.
Автономная AI-модель приносит максимальную пользу только при плотной интеграции в существующий IT-ландшафт компании. После оптимизации и квантования мы оборачиваем нейросеть в отказоустойчивый API-сервер для обработки высоконагруженных инференс-запросов.
Адаптированный ИИ-ассистент бесшовно подключается к CRM, ERP или корпоративным мессенджерам. Это позволяет автоматизировать рутинные операции с данными:
Одной из главных технических проблем при fine-tuning является «катастрофическое забывание» (catastrophic forgetting). В процессе усвоения узкоспециализированной информации из нового датасета нейросеть может частично утратить базовую логику, навыки связного изложения или способность решать общие задачи.
Для предотвращения этого эффекта мы применяем регуляризацию данных и подмешиваем к целевому датасету проверочные инструкции из исходного корпуса. Строгий контроль функции потерь (loss) и непрерывное валидационное тестирование на смешанных бенчмарках гарантируют, что дообученная модель сохранит интеллект базовой версии, безупречно освоив при этом новую специализацию.
Выберите тип задачи, расскажите о ней, каким вы видите решение и результат:
ИП Липаткин Павел Евгеньевич ИНН 661224380098 ОГРНИП 325665800174229