Без выходных: 9:30–20:00
Организация озер данных для централизованного хранения
Обучение моделей на кластерах для ускорения процесса
Обработка данных в реальном времени с помощью AI
Глубокая аналитика и предиктивное моделирование
Делимся примерами проектов, где SEO, разработка и комплексный подход приносят измеримый рост трафика, заявок и продаж.
Все кейсыКомплексно оптимизировали интернет-магазин вентиляционных решеток и увеличили поисковый трафик с 2,7 до 11,2 тыс. визитов в месяц
Начало работ: май 2025
Тематика: Вентиляция, Производство.
Услуги: SEO-продвижение
Результат: х4 трафик из поисковых систем
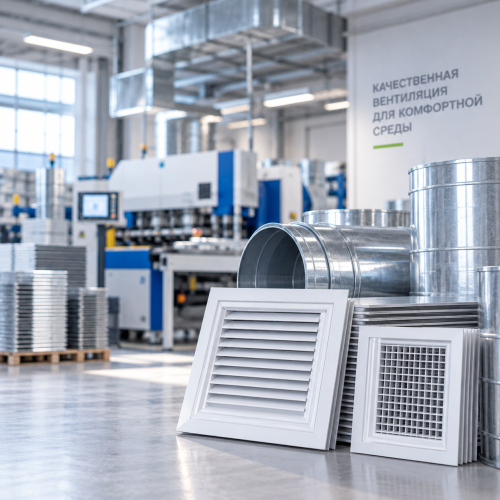
Разработали сайт, расширили семантику и поисковую видимость — органический трафик вырос с нуля до 19,3 тыс. визитов в месяц
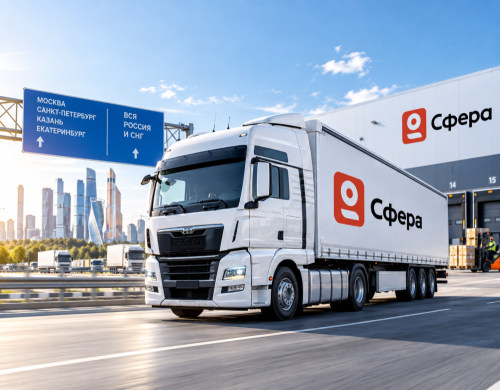
Разработка и SEO продвижение сайта грузоперевозок: сформировали стабильный органический трафик — первые 100+ посетителей из поисковых систем в день.
Оставьте заявку — обсудим задачу и подберём решение под ваш бизнес.
Услуга включает полный комплекс инжиниринговых и аналитических работ для построения масштабируемой инфраструктуры. Мы выполняем проектирование централизованных хранилищ, развертывание вычислительных кластеров, создание ML-моделей для работы с большими данными, а также настройку сервисов потоковой аналитики, автоматизированных пайплайнов и BI-интеграций.
Организация единых озер данных для сбора, структурирования и безопасного хранения информации из разрозненных источников. Настройка процессов ETL и ELT для регулярного формирования чистых датасетов, готовых к дальнейшему анализу и использованию в алгоритмах машинного обучения.
Разработка сайтов, SEO-продвижение и внедрение AI-решений для бизнеса.
Senior Web Developer · SEO · AI
Процесс реализации проектов построения систем искусственного интеллекта и работы с большими данными организован как последовательный переход от аудита к поддержке. Мы начинаем с исследования инфраструктуры, проектируем архитектуру и развертываем кластеры, после чего переходим к настройке пайплайнов, разработке ML-моделей, их тщательному тестированию, запуску в продакшн и сопровождению.
На старте специалисты детально исследуют текущее состояние информационных активов клиента, оценивают доступные datasets, качество исходных сведений и используемые серверные мощности. Это необходимо для проведения анализа Big Data с AI и определения фактической технической готовности компании к полномасштабному внедрению.
На этом шаге закладывается фундамент будущей системы: подбирается стек технологий для организации Data Lake, планируются вычислительные clusters и схема распределенных вычислений distributed computing. Результатом становится подробный технический план для стабильной работы под высокими нагрузками.
Инженеры осуществляют сборку и базовую конфигурацию программно-аппаратного комплекса в облачной среде или на локальных мощностях заказчика. Выполняется настройка средовых параметров для распределенной обработки, обеспечивающая работу ИИ с большими массивами данных и бесшовное масштабирование при росте нагрузки.
На данном этапе выстраиваются автоматические ETL- и ELT- pipelines, обеспечивающие извлечение, фильтрацию, чистку и трансформацию сведений из разрозненных источников. Систематизируются как накопившиеся массивы, так и входящие потоковые данные для дальнейшего формирования витрин и обучения алгоритмов.
Команда разработки создает алгоритмы машинного обучения, проводит серию экспериментов и запускает distributed ML для обучения нейросетей на подготовленных массивах. Итерационный тюнинг гиперпараметров позволяет довести создаваемые models до требуемого уровня точности бизнес-прогнозов.
Завершенные модели проходят проверку в изолированном контуре на контрольных выборках и в эмулированных нагрузочных условиях. Эксперты оценивают точность, время отклика, устойчивость к сбоям и корректность функционирования AI analytics перед интеграцией в реальные бизнес-процессы.
Обученные алгоритмы интегрируются в существующий IT-ландшафт организации, настраиваются необходимые API-интерфейсы и активируются streams для работы в реальном времени. Внедрение AI analytics завершает переход от тестовой разработки к промышленному использованию готовой системы.
После запуска осуществляется непрерывный отслеживающий контроль точности работы алгоритмов, предотвращается деградация показателей (data drift) и проводится регулярное переобучение. Поддержка инфраструктуры гарантирует соответствие системы развивающимся бизнес-кейсам и растущим объемам информации.
Внедрив искусственный интеллект и Big Data, компании избавляются от технологических ограничений, когда объемы информации растут быстрее, чем возможности системы по ее обработке. Данный подход актуален при критическом замедлении отчетности, низкой точности аналитических прогнозов и разрозненности архивов. Разработка Big Data и AI-решений позволяет быстро трансформировать информационные массивы в управляемый бизнес-актив.
Когда выгрузка стандартных отчетов занимает длительное время, а существующие BI-системы зависают при попытке обработать историю за прошлые периоды, бизнес теряет оперативность. Распределенные вычисления на базе clusters позволяют снизить нагрузку и вернуть скорость аналитики. Переход на масштабирование инфраструктуры обеспечивает моментальный доступ к информации, подготавливая почву под distributed computing и принятие обоснованных управленческих решений без задержек.
При использовании стандартных математических моделей ключевые бизнес-прогнозы теряют точность, так как классические алгоритмы не способны учитывать поведенческие факторы, тексты, логи и внешние индикаторы. Технологии, комбинирующие AI и большие данные, позволяют эффективно обрабатывать подобные массивные datasets. Внедрение нейросетей открывает доступ к глубокому анализу сложных связей, восстанавливая предиктивную точность бизнеса через алгоритмическое машинное обучение.
Наличие изолированных баз данных и несистемных хранилищ приводит к дублированию сведений и делает невозможным формирование единой картины бизнес-процессов. Из-за отсутствия связей создание надежных моделей машинного обучения становится непростой задачей. Развертывание Data Lake в комбинации с автоматизированными pipelines позволяет объединить разнородные потоки в структурированный массив, который гарантирует высокую скорость обработки данных для аналитики.
Оценим рынок, конкурентов и потенциал
Подберём оптимальные каналы и инструменты
Покажем реальные ожидаемые результаты
Составим пошаговый план сроки и бюджет
Покажем, как работаем на реальных кейсах
Делимся опытом и результатами
Внедрение интеллектуальных систем работы с Big Data преобразует массивы информации в измеримые финансовые и операционные результаты. Компания получает гибкую платформу для точного прогнозирования, моментального реагирования на рыночные изменения и автоматизации принятия решений. Использование технологий AI и больших данных открывает новые возможности для роста доходов и снижения издержек.
Комплексный анализ Big Data с AI превращает ранее неиспользуемые архивы и корпоративные datasets в ценный бизнес-актив. Выявление скрытых закономерностей позволяет находить нетривиальные точки роста, запускать востребованные продукты и открывать дополнительные источники прибыли на основе собственных данных.
Сквозная обработка и анализ входящих streams дает возможность принимать решения непосредственно в момент совершения событий. Технологии streaming обеспечивают моментальное выявление фрод-транзакций, динамическое управление ценообразованием и непрерывную адаптацию к поведению пользователей.
Многофакторные ML-models, обученные на масштабных исторических выборках, минимизируют ошибки при планировании цепей поставок, закупок и оборудования. Алгоритмы машинного обучения учитывают тысячи параметров, обеспечивая высокую точность предсказания спроса и предотвращения рисков.
Архитектура, в основе которой лежит distributed computing и оптимизированные вычислительные clusters, гарантирует стабильную работу под высокой нагрузкой. Построенная инфраструктура легко проходит процедуру масштабирования, справляясь с любым приростом объема информации без потери скорости.
Инструменты big data analytics и алгоритмы AI for Big Data формируют точный профиль каждого пользователя. Оценка полного анамнеза взаимодействий дает возможность делать релевантные персональные предложения, существенно увеличивать повторные продажи и выстраивать долгосрочную лояльность.
Настроенные дата-pipelines и автоматическое внедрение AI analytics снимают с аналитиков рутинные задачи по обработке сырой информации. Специалисты получают готовые управленческие инсайты, что ускоряет принятие ключевых решений и повышает общий операционный КПД компании.
Проектирование инфраструктуры под AI и большие данные требует кардинального отказа от традиционных монолитных СУБД. Главная задача архитектора — разделить слои хранения и вычислений, обеспечив беспрепятственный доступ к данным для алгоритмов машинного обучения. Озеро данных (Data Lake) становится единой точкой сборки сырой информации — от структурированных таблиц до транзакционных логов и полуструктурированного JSON-потока.
Фундаментом такой системы выступает концепция decoupled storage & compute, позволяющая независимо масштабировать хранилище и вычислительные ресурсы. При организации взаимодействия компонентов используются следующие архитектурные шаблоны:
Когда datasets превышают операционную память одного сервера, вычисления распределяются по clusters. Для этого применяется специализированный фреймворк распределенного машинного обучения (distributed ML). На уровне хранения применяются файловые системы HDFS или S3-совместимые объектные хранилища. Очистка, очищение и подготовка данных реализуются с помощью Apache Spark и PySpark, распределяющих задачи между узлами кластера.
Обучение глубоких нейросетей требует аппаратного ускорения и соответствующего софта. Мы применяем системные инструменты масштабирования:
Практическая ценность, которую дает искусственный интеллект и Big Data, разрушается без автоматизации развертывания. Практика MLOps превращает изолированные исследования в воспроизводимый инженерный процесс. Главная сложность здесь — деградация моделей со временем из-за изменения поведения пользователей или внешних факторов (Data Drift и Concept Drift).
Автоматизированные pipelines берут на себя контроль за качеством моделей в продакшене. Решение включает три ключевых слоя управления:
Для задач, где задержка в реагировании ведет к прямым финансовым потерям, классический батчинг не подходит. В таких случаях выстраивается streaming-архитектура. Потоковый анализ Big Data с AI позволяет обрабатывать входящие события в реальном времени с задержками до сотен миллисекунд. Это ключевой элемент для работы антифрод-систем, алгоритмов динамического ценообразования и мониторинга промышленного оборудования.
Основу потоковой экосистемы образуют распределенные брокеры сообщений и специализированные движки аналитики:
Результаты работы сложных математических моделей не должны оставаться внутри кода. Чтобы бизнес получал практическую выгоду, выходы ML-моделей интегрируются в корпоративный контур. Успешное внедрение AI analytics предполагает обогащение привычных BI-дашбордов предиктивными оценками: вероятностью оттока клиентов, прогнозом спроса или LTV.
Передача готовых предсказаний из среды машинного обучения в пользовательские интерфейсы реализуется через проверенные бизнес-кейсы интеграции:
Выберите тип задачи, расскажите о ней, каким вы видите решение и результат:
ИП Липаткин Павел Евгеньевич ИНН 661224380098 ОГРНИП 325665800174229