Без выходных: 9:30–20:00
Быстрое извлечение точных данных из файла
Строгий контроль прав доступа для пользователей
Точная генерация ответов по вашей базе знаний
Удобное внедрение в текущие рабочие системы
Делимся примерами проектов, где SEO, разработка и комплексный подход приносят измеримый рост трафика, заявок и продаж.
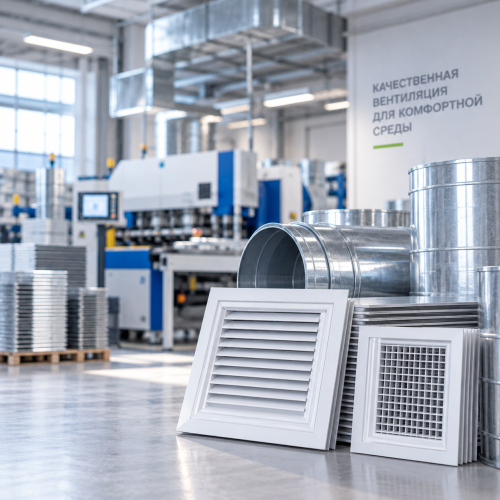
Все кейсыКомплексно оптимизировали интернет-магазин вентиляционных решеток и увеличили поисковый трафик с 2,7 до 11,2 тыс. визитов в месяц
Начало работ: май 2025
Тематика: Вентиляция, Производство.
Услуги: SEO-продвижение
Результат: х4 трафик из поисковых систем
Разработали сайт, расширили семантику и поисковую видимость — органический трафик вырос с нуля до 19,3 тыс. визитов в месяц
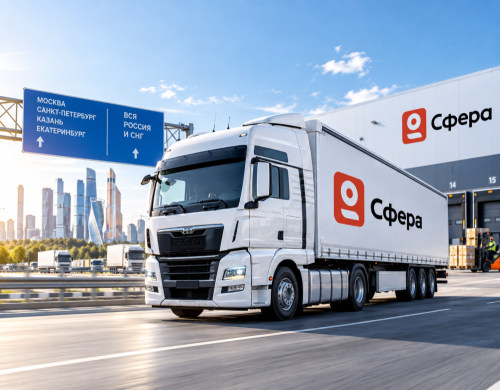
Разработка и SEO продвижение сайта грузоперевозок: сформировали стабильный органический трафик — первые 100+ посетителей из поисковых систем в день.
Оставьте заявку — обсудим задачу и подберём решение под ваш бизнес.
В состав работы по созданию системы входят извлечение и OCR-обработка файлов, их векторизация, настройка RAG-генерации ответов, создание удобного пользовательского интерфейса, а также глубокая интеграция ролевой модели прав доступа с разграничением видимости информации.
Автоматическая загрузка и парсинг файлов в форматах PDF, DOCX и TXT. Включает опцию оптического распознавания текста (OCR) для сканированных страниц и правильное разбиение исходного массива на фрагменты (chunks) для корректной последующей обработки.
Разработка сайтов, SEO-продвижение и внедрение AI-решений для бизнеса.
Senior Web Developer · SEO · AI
Разработка интеллектуального поиска проходит последовательно: от аудита данных и выбора архитектуры до векторизации, настройки языковых моделей и интеграции. Каждая стадия логически вытекает из предыдущей, обеспечивая постепенную трансформацию разрозненных корпоративных документов в точную, безопасную и готовую к эксплуатации поисковую систему с контролем прав доступа.
На старте специалисты проводят сбор информации об имеющихся корпоративных хранилищах, типах документов и их объемах. Оцениваются целевая аудитория системы и бизнес-задачи, определяется перечень необходимых форматов, а также фиксируются требования к функционалу и будущей скорости работы сервиса.
На основе собранных требований подбираются оптимальные языковые модели (LLM) и нейросети для создания эмбеддингов, выбирается векторная база данных. Проектируются пайплайны обработки входящей информации и общая архитектура RAG-решения для корректного взаимодействия всех модулей.
Команда разрабатывает скрипты автоматического извлечения текста из различных форматов, включая PDF и DOCX. Для работы со сканированными документами подключаются технологии OCR, после чего настраивается алгоритм разбиения текстов на оптимальные смысловые фрагменты — chunks.
Извлеченные фрагменты документов переводятся в векторную форму с использованием специализированных нейросетей. Сформированные embeddings вместе с метаданными загружаются в векторную базу данных, что формирует основу для будущего семантического поиска с учетом контекста.
Осуществляется интеграция языковой модели с созданным векторным индексом и тонкая настройка системных промптов. Пайплайн RAG оптимизируется для извлечения релевантного контекста и формирования точных ответов на вопросы пользователей без проявления галлюцинаций LLM.
Создается удобный пользовательский веб-интерфейс для ввода запросов и просмотра результатов. Параллельно разрабатывается и проектируется REST API, обеспечивающий бесшовное встраивание поискового движка в существующие корпоративные порталы, интранет или CRM-системы.
Проводится комплексная проверка релевантности выдачи и качества сгенерированных ответов. Настраиваются и тестируются механизмы фильтрации по метаданным для строгого соблюдения прав доступа, а также выполняется финальная оптимизация скорости обработки входящих запросов.
Готовая система разворачивается в закрытом контуре компании (on-premise) или в облаке. Проводится обучение персонала, запускаются процессы автоматического фонового обновления индекса при изменении файлов, а также организуется регулярный технический мониторинг системы.
Внедрение интеллектуального поиска становится критически важным, когда традиционные инструменты не справляются с объемами корпоративных данных. Если сотрудники тратят рабочее время на ручной перебор файлов, а поиск по ключевым словам не дает релевантных ответов, текущий подход к управлению знаниями замедляет бизнес-процессы. AI-система становится необходимым решением для трансформации хаотичных архивов в единый интеллектуальный ресурс.
Компания обладает терабайтами разрозненных данных — от юридических договоров и регламентов до технических инструкций, хранящихся в разных форматах. В такой ситуации стандартные папки становятся «кладбищем знаний», где поиск нужного фрагмента превращается в невозможную задачу. Интеллектуальный поиск позволяет мгновенно структурировать и находить информацию внутри массивов данных, превращая пассивный архив в активный инструмент для принятия взвешенных бизнес-решений.
В отделах поддержки, продаж или юридической экспертизы скорость ответа определяет лояльность клиентов. Когда специалисты вынуждены вручную изучать десятки многостраничных PDF или регламентов, чтобы ответить на простой вопрос, продуктивность падает, а риск ошибки возрастает. Внедрение AI-поиска автоматизирует извлечение точных данных из документации, позволяя сотрудникам отвечать клиентам за секунды, а не часы, значительно повышая качество клиентского сервиса.
Стандартные поисковые системы в корпоративных порталах часто работают исключительно по точному совпадению ключевых слов, игнорируя контекст, синонимы и смысл запроса. Это приводит к выдаче сотен бесполезных документов, среди которых нет нужной информации. Интеллектуальный семантический поиск понимает намерения пользователя и суть заданного вопроса, обеспечивая высокую точность выдачи и позволяя находить ответы даже тогда, когда формулировки в запросе и документе различаются.
Оценим рынок, конкурентов и потенциал
Подберём оптимальные каналы и инструменты
Покажем реальные ожидаемые результаты
Составим пошаговый план сроки и бюджет
Покажем, как работаем на реальных кейсах
Делимся опытом и результатами
Внедрение интеллектуального поиска трансформирует работу с корпоративными знаниями, превращая объемные архивы в мгновенный источник точной информации. Бизнес получает измеримый рост операционной эффективности, надежную защиту конфиденциальных сведений и существенную экономию ресурсов за счет автоматизации обработки запросов и мгновенного доступа к нужным данным.
Сотрудники получают точные ответы на сложнейшие запросы за считанные секунды вместо долгих часов ручного просмотра файлов. Это устраняет простои в рабочих процессах и позволяет специалистам мгновенно находить ключевую информацию в регламентах, договорах и технических архивах компании.
Использование семантического анализа и технологии RAG обеспечивает предоставление корректных ответов, основанных строго на содержимом ваших документов. Система полностью исключает генерацию недостоверных фактов и находит нужный смысловой фрагмент даже при неточных формулировках.
Быстрый доступ к корпоративной базе знаний позволяет подразделениям клиентской поддержки, продаж и юридическому отделу оперативно консультировать заказчиков и принимать решения. Это значительно увеличивает объем обрабатываемых задач без расширения штата.
Каждый предоставленный ответ сопровождается прямой ссылкой на конкретную страницу и абзац исходного документа в формате PDF или DOCX. Пользователи могут в один клик проверить контекст и убедиться в достоверности найденных данных без лишних поисковых действий.
Архитектура решения строго соблюдает корпоративные политики безопасности и ролевые модели. Каждая выдача формируется с учетом прав конкретного сотрудника, что полностью предотвращает утечку конфиденциальных сведений и несанкционированный просмотр закрытых файлов.
Оптимизация работы с информацией существенно сокращает косвенные издержки бизнеса. Автоматизация поиска снижает стоимость адаптации новых сотрудников, ускоряет передачу накопленных знаний и позволяет рационально использовать оплачиваемое время высококлассных экспертов.
Технология Retrieval-Augmented Generation (RAG) объединяет возможности мощных векторных баз данных и генеративных языковых моделей для работы с закрытыми знаниями организации. Процесс строится на двухэтапной обработке запроса: сначала система извлекает наиболее релевантные фрагменты из индексированного массива корпоративной информации, а затем подает их в качестве контекста языковой модели для формирования финального ответа.
В отличие от традиционных моделей, RAG работает строго в рамках предоставленного контекста, что предотвращает утечку внешних данных и исключает некорректную генерацию. Архитектура адаптирована для работы с гигантскими объемами неструктурированной информации и масштабируется под любые задачи предприятия.
Ключевые инженерные компоненты архитектуры RAG:
Подбор оптимизированной нейросети зависит от требований к конфиденциальности, доступных вычислительных мощностей и языка обрабатываемых массивов. Для локальной установки внутри изолированного контура (on-premise) применяются open-source модели семейств Llama 3, Qwen 2.5 или Mistral, прошедшие процедуру тонкой настройки (fine-tuning) под предметную область компании.
В случаях, когда ограничения по хранению данных допускают использование внешних API, подключаются проприетарные нейросети, демонстрирующие высокий уровень глубокого анализа длинных контекстных окон. Выбор конкретного семейства моделей напрямую определяет скорость генерации ответов и общие затраты на инфраструктуру.
Критерии подбора LLM для корпоративных задач:
Универсальность интеллектуального поиска обеспечивается за счет API-first подхода. Поисковый движок поставляется в виде независимого микросервиса, который легко встраивается в текущий IT-ландшафт организации: корпоративные порталы (Bitrix24, SharePoint), базы знаний (Confluence, Notion), а также в привычные рабочие мессенджеры (Telegram, Slack, TrueConf).
Благодаря гибкой настройке webhook-уведомлений и коннекторов, индексация обновлений происходит практически мгновенно. Как только сотрудник загружает новую инструкцию или регламент в CRM-систему, алгоритм векторизирует изменения и сразу делает их доступными для всех авторизованных пользователей.
Интеграция с корпоративной инфраструктурой включает интеграцию с сервисами аутентификации (Active Directory, LDAP, Keycloak). Это позволяет нативно пробрасывать права доступа пользователя в поисковый запрос: система физически не сможет вернуть фрагмент документа, к которому у сотрудника нет разрешения на чтение.
Классический лексический поиск (BM25, ElasticSearch) ищет точные совпадения символьных строк. Если сотрудник ищет "правила оформления отпуска", но в регламенте написано "порядок предоставления ежегодного отдыха", традиционный поиск вернет пустую выдачу или нерелевантную информацию. Это создает высокие требования к точности формулировок пользователей.
Семантический поиск (Semantic Search) преобразует слова и предложения в математические векторы, отражающие истинный смысловой контекст. Система понимает синонимы, опечатки, профессиональный жаргон и контекстные связи. Запрос "как получить рабочий ноутбук" корректно соотносится с разделом регламента "Выдача вычислительной техники новым штатным единицам".
В современных корпоративных системах наиболее эффективные результаты показывает гибридный поиск. Он объединяет лексическое соответствие артикулов, дат и точных названий с глубоким семантическим пониманием естественного языка, гарантируя максимальную полноту и точность выдачи.
Выберите тип задачи, расскажите о ней, каким вы видите решение и результат:
ИП Липаткин Павел Евгеньевич ИНН 661224380098 ОГРНИП 325665800174229